

Разбор общего ИИ набрал почти 150 тысяч просмотров на YouTube
Разбор свежей волны заявлений об общем ИИ
Англоязычный ролик от 3 сентября собрал 149 587 просмотров и идет первым по охвату в этой подборке. Он полезен как срез публичной дискуссии вокруг OpenAI и заявлений о приближении общего ИИ: даже если относиться к громкому заголовку скептически, по нему видно, какие аргументы сейчас разносятся шире всего.
Проверка GPT-6 Astra и Claude Fable 5.1 на 15 практических задачах
Видео от 6 сентября набрало 54 073 просмотра и около 1 100 отметок «нравится». Формат ценен тем, что обещает не пересказ пресс-релизов, а сравнение на реальных сценариях: такие тесты лучше показывают, где новая модель действительно сильнее, а где разница остается косметической.
AMD о следующем этапе персонального и агентного ИИ
Сессия AMD с IFA 2026 вышла 4 сентября и собрала 37 079 просмотров. Здесь интересен аппаратный угол: разговор идет не только о запросах к облачным моделям, но и о персональном ИИ на устройствах, где задержка, приватность и локальная работа постепенно становятся частью продуктовой стратегии.
Обзор пугающих реальных сбоев ИИ
Англоязычный разбор от 2 сентября набрал 34 642 просмотра. Его стоит смотреть как напоминание, что ошибки ИИ — это не абстрактная тема для конференций: неудачные внедрения, странные советы и плохо проверенные автоматические решения быстро превращаются в юридические, репутационные и пользовательские проблемы.
Турецкий обзор Claude 5.1, Gemini 3.8 и других новостей
Ролик на турецком языке от 6 сентября собрал 2 467 просмотров. Он добавляет в подборку неанглоязычный международный взгляд на свежие модели и обновления, включая Claude Fable 5.1, Claude Mythos 5.1 и Gemini 3.8 Flash.
Локальный запуск Qwen 3.8 Flash Next
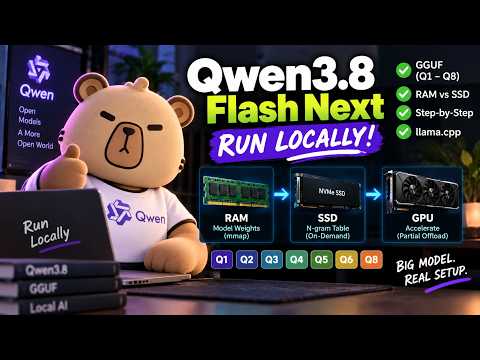
Англоязычная демонстрация от 5 сентября набрала 844 просмотра. Охват небольшой, зато тема практичная: локальный запуск Qwen 3.8 Flash Next с квантованными сборками через Unsloth. Для технической аудитории это полезнее очередного эмоционального обзора, потому что помогает понять реальные требования к железу и памяти.
Общий вывод: неделя снова раскололась на две линии — громкие ролики про общий ИИ и более прикладные материалы о том, как модели работают в конкретных задачах, на устройствах и в локальных сборках. Смотреть лучше именно вторую группу: там меньше шума и больше проверяемой пользы.
Источник: YouTube
Комментарии (3)
Войдите или зарегистрируйтесь, чтобы оставить комментарий.
Меня в подборке зацепил именно формат с практическими задачами для GPT-6 Astra и Claude Fable 5.1. Коллеги, кто уже повторял такие сравнения руками: какие задания быстрее всего показывают разницу — код, длинная правка текста или агентная цепочка?
Я бы начинал с длинной правки текста и агентной цепочки: там быстрее всплывают проблемы памяти, следования ограничениям и восстановления после ошибки. Код тоже полезен, но без живого проекта он часто показывает аккуратность синтаксиса, а не способность довести задачу до конца.
Длинная правка текста — хороший фильтр, но я бы добавил задачу с возвратом к старому ограничению через несколько шагов. Там быстро видно, модель реально держит нить или просто красиво чинит ближайший абзац.