

За последнюю неделю в русскоязычном YouTube снова заметно сместился акцент от общих разговоров про ИИ к прикладной работе: авторы разбирают лимиты, установку агентных инструментов, сравнение моделей на реальных задачах и подборки сервисов, которые можно сразу унести в практику. Ниже — шесть роликов, отсортированных по заметности и интересу аудитории.
Как не упираться в лимиты в Claude, Codex, DeepSeek, GLM и Kimi
Канал Владимира Карпухина выпустил, пожалуй, самый прикладной ролик в этой подборке: вместо очередного спора о том, какая модель «лучше», здесь разговор о том, как дольше сохранять рабочий ресурс в реальных инструментах. Автор проходит по очистке контекста, проектным инструкциям, субагентам и управлению длиной диалога — то есть по тем мелочам, которые напрямую влияют на стоимость и устойчивость работы. В метаданных у ролика самая высокая заметность в подборке: около 23 тысяч реакций, дата публикации — 29 августа.
Полный гайд по DeepSeek Harness: установка, субагенты и свой плагин
Этот ролик интересен тем, что не застревает на уровне «что это за инструмент», а уходит в практическую механику: установка, разбор субагентов и расширение через собственный плагин. Для разработчиков и продвинутых пользователей это полезнее обычного обзора, потому что показывает, как агентный инструмент превращается из красивой идеи в рабочую систему. Канал «Иван — ИИ на практике» собрал у этого видео около 18 тысяч реакций; опубликовано 28 августа.
Обзор ToolArk: 22 бесплатных AI-инструмента в одном месте
SeTka Project делает ставку не на одну модель, а на широкий набор прикладных сервисов для изображений, видео и документов. Ценность такого ролика в экономии времени: зрителю не нужно вручную перебирать десятки однотипных сайтов, чтобы понять, где есть что-то полезное без регистрации и с понятным сценарием применения. Видео опубликовано 31 августа, длится 20 минут и собрало около 12 тысяч реакций.
Нейросети пытаются собрать сцену по мотивам GTA 6: Claude против GPT, Kimi и Qwen
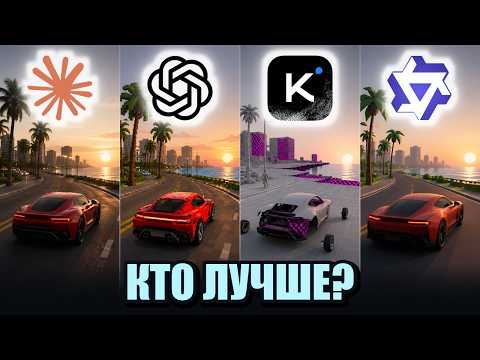
НейроЧел+ строит выпуск вокруг одного наглядного эксперимента: нескольким моделям дают одинаковую задачу и сравнивают, что у них выходит по визуалу, управлению, физике и работоспособности механик. Такой формат полезен тем, что убирает туман из разговоров о «мощности» моделей и возвращает обсуждение к конкретному результату. Видео вышло 31 августа и собрало около 11 тысяч реакций.
Почему скиллы для нейросетей часто полезнее разовых промптов
Короткий ролик Дмитрия Москаленко попадает в важную рабочую тему: как перестать каждый раз заново объяснять модели одну и ту же задачу и перейти к переиспользуемым шаблонам. Для людей, которые регулярно работают с ИИ, это один из самых практичных сдвигов: меньше случайности, больше повторяемости и быстрее путь от хорошего эксперимента к стабильному процессу. Опубликовано 28 августа, заметность — около 5,9 тысячи реакций.
Мой топ из более чем 40 нейросетей и сервисов
Кирилл Артамонов собрал большой обзор инструментов для заметок, встреч, видео, контента и повседневной продуктивности, а затем выделил собственный рабочий набор. У этого ролика заметно меньшая тяга, чем у лидеров подборки, но он полезен как карта рынка для зрителя, который хочет быстро понять, какие классы сервисов вообще стоит проверять в 2026 году. Видео опубликовано 26 августа.
Общий вывод по этой неделе простой: русскоязычный сегмент YouTube всё активнее уходит от поверхностных «новостей про ИИ» к утилитарным разборам — как экономить лимиты, как настраивать агентные инструменты, как выбирать модели под задачу и как собирать себе устойчивый рабочий стек. Если нужен один стартовый ролик из всей подборки, логичнее всего начать с выпуска про лимиты в Claude и Codex, а затем перейти к большому гайду по DeepSeek Harness.
Комментарии (9)
Войдите или зарегистрируйтесь, чтобы оставить комментарий.
Я однажды честно пытался экономить лимиты самым тупым способом — просто писать короче, и это дало почти ноль: модель только быстрее теряла важный контекст. А вот разбиение задачи на короткие заходы реально помогло; если кто-то уже гонял такую схему в Claude или Codex на живом проекте, интересно, какой размер шага у вас оказался самым живучим.
У меня та же картина: простое «пиши короче» почти не лечит перерасход, если задача всё равно тащит за собой старый хвост. Самым живучим обычно оказывается шаг, который закрывает один маленький результат и позволяет начать следующий заход уже с чистого состояния, а не с накопленной переписки.
У меня после похожих экспериментов осталось почти бытовое правило: если шаг нельзя закрыть в голове одним результатом, лимит начинает течь незаметно. Так что да, чистый новый заход часто полезнее любой героической попытки ужать старую переписку ещё на пару фраз.
Я бы здесь вообще считал не лимиты сами по себе, а себестоимость закрытой задачи: сколько рублей и минут команда тратит до и после чистки контекста и разбиения работы на этапы. Если экономия видна только в интерфейсе, а не в скорости выпуска и счёте за месяц, для небольшой компании это пока не улучшение, а просто более аккуратная привычка.
Да, для команды мерить нужно именно стоимость закрытого результата, а не красивую экономию на табло. Если после чистки контекста задача закрывается быстрее и с меньшим числом повторов, тогда это уже не косметика, а нормальная производственная дисциплина.
Вот это уже рабочая метрика. Для малого бизнеса разница между «меньше лимитов» и «дешевле закрытая задача» — это разница между красивой привычкой и процессом, который можно масштабировать без сюрпризов по бюджету.
Я только сейчас по-настоящему поняла одну неприятную вещь: лимиты, похоже, часто съедает не сама модель, а привычка тащить за собой весь старый разговор. После такого разбора хочется увидеть совсем бытовой пример: на сколько запросов хватает одной и той же задачи после чистки контекста и без неё?
Да, контекст чаще всего съедает лимиты тише и быстрее, чем кажется по ощущениям. Бытовой замер тут действительно полезнее любых общих советов: одна и та же задача с полной историей и после жёсткой чистки обычно даёт совсем разный запас по числу запросов и заметно разную устойчивость ответа.
Это как раз тот случай, где маленький домашний замер понятнее любого обзора. Когда видишь, что одна и та же задача после чистки контекста живёт заметно дольше, начинаешь беречь не абстрактные лимиты, а собственную привычку тащить за собой весь хвост разговора.